 ซอฟต์แวร์
 แอปพลิเคชันบนมือถือ
 เช็คความเร็วเน็ต (Speedtest)
 เช็คไอพี (Check IP)
 เช็คเลขพัสดุ
 สุ่มออนไลน์
 เครื่องมือคำนวณวันออนไลน์
Unicode คืออะไร ? มีกี่ประเภท ? ทำงานอย่างไร ? ต่างจาก ASCII อย่างไร ?

 moonlightkz

Unicode คืออะไร ?
ในยุคแรกเริ่มของคอมพิวเตอร์ การแสดงผลข้อความบนหน้าจอไม่ใช่เรื่องซับซ้อน เนื่องจากระบบส่วนใหญ่ถูกสร้างขึ้นโดยผู้พัฒนาที่ใช้ภาษาอังกฤษเป็นหลัก แต่เมื่อเทคโนโลยีสารสนเทศขยายตัวไปทั่วโลก ปัญหาใหญ่ที่ตามมาคือ คอมพิวเตอร์ในแต่ละประเทศไม่สามารถสื่อสารภาษาของกัน และกันได้ เอกสารภาษาไทยที่ส่งไปเปิดบนเครื่องต่างประเทศอาจกลายเป็นตัวอักษรขยะอ่านไม่รู้เรื่อง หรือที่เรียกกันว่า "ภาษาต่างดาว"
สาเหตุเกิดจากการที่ระบบคอมพิวเตอร์ในยุคก่อนใช้มาตรฐานการเข้ารหัส (Character Encoding) ที่แตกต่างกันซึ่งก็มีอยู่นับร้อยรูปแบบ ข้อจำกัดนี้จึงเป็นจุดเริ่มของการสร้าง "Unicode" มาตรฐานสากลที่เข้ามาแก้ปัญหา และกลายเป็นรากฐานสำคัญของ อินเทอร์เน็ต (Internet) และ ระบบปฏิบัติการ (OS) ของ คอมพิวเตอร์ ในปัจจุบัน ลองมาดูหัวข้อหลัก ๆ ของบทความนี้กันเลย
Unicode คืออะไร ? (What is Unicode ?)
Unicode (ยูนิโคด) เป็นมาตรฐานอุตสาหกรรมสากลสำหรับกำหนดรหัสตัวอักษร, สัญลักษณ์ และไอคอนต่าง ๆ ที่ใช้ในระบบคอมพิวเตอร์ทั่วโลก
หลักการของ Unicode คือการมอบ "หมายเลขรหัสที่ไม่ซ้ำกัน" (Unique Number) ให้แก่ตัวอักษรทุกตัว ไม่ว่าจะอยู่ในระบบปฏิบัติการ, โปรแกรม หรือภาษาใดก็ตาม
ตัวอย่างเช่น
- ตัวอักษร A จะมีรหัสประจำตัวคือ U+0041
- ตัวอักษร ก (ภาษาไทย) มีรหัสประจำตัวคือ U+0E01
- อีโมจิ (Emoji) 😊 มีรหัสประจำตัวคือ U+1F60A
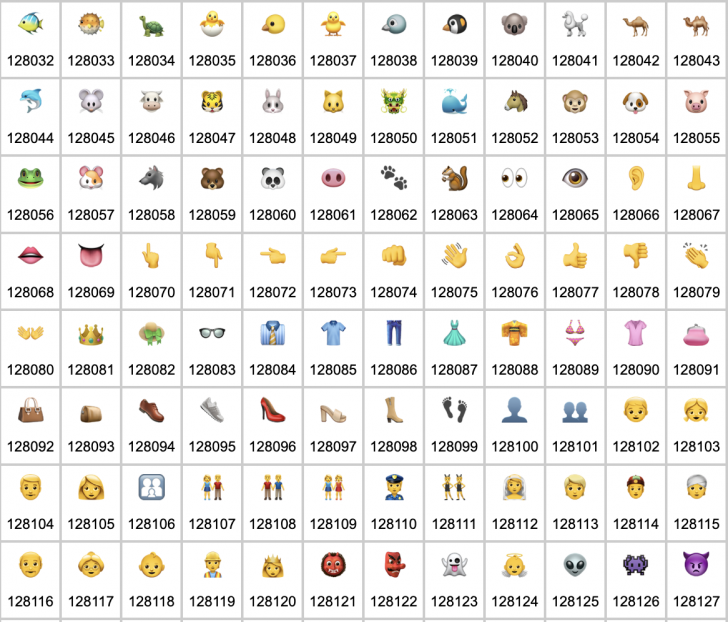
ภาพจาก : https://www.vertex42.com/ExcelTips/unicode-symbols.html
ด้วยการระบุรหัสที่เป็นหนึ่งเดียวนี้นั่นเอง ทำให้คอมพิวเตอร์ที่ต่างระบบกัน ไม่ว่าจะเป็น วินโดวส์ (Windows), แมคโอเอส (macOS), ลีนุกซ์ (Linux), แอนดรอด์ (Android), ไอโอเอส (iOS) หรือ เซิร์ฟเวอร์ (Server) บน คลาวด์ (Cloud) สามารถเข้าใจ และแสดงผลตัวอักษรตรงกันได้อย่างถูกต้อง
Unicode ต่างจาก ASCII อย่างไร ? (What is the difference between Unicode and ASCII ?)
| คุณสมบัติ | ASCII | Unicode |
| ย่อมาจาก | American Standard Code for Information Interchange | Universal Character Encoding Standard |
| ขนาดของข้อมูล | คงที่ 7 บิต บางครั้งใช้ 8 บิต หรือ 1 ไบต์ | หลากหลาย ตั้งแต่ 1 ถึง 4 ไบต์ |
| จำนวนตัวอักษรที่รองรับ | 128 ตัวอักษร หรือ 256 ตัวอักษรสำหรับ Extended ASCII | รองรับมากกว่า 149,000+ ตัวอักษร และรองรับได้สูงสุดถึง 1.1 ล้านตัว |
| ภาษาที่รองรับ | ภาษาอังกฤษพื้นฐาน, ตัวเลข, สัญลักษณ์ควบคุม | เกือบทุกภาษาทั่วโลก, สัญลักษณ์ทางคณิตศาสตร์, อีโมจิ ฯลฯ |
| การรองรับย้อนหลัง | เป็นมาตรฐานดั้งเดิม | ออกแบบให้ 128 ตัวแรกตรงกับ ASCII เพื่อรองรับย้อนหลัง (Backward Compatible) |
สรุปง่าย ๆ ASCII เปรียบเหมือน "พจนานุกรมภาษาอังกฤษขนาดเล็ก" ที่มีคำจำกัด ส่วน Unicode คือ "สารานุกรมภาษาโลก" ที่เก็บรวบรวมภาษา, ตัวอักษรโบราณ สัญลักษณ์ และอีโมจิ เอาไว้ทั้งหมด
ประเภทของ Unicode (Types of Unicode Encoding)
เนื่องจาก Unicode กำหนดเพียง "ตัวเลขรหัส" (Code Point) แต่คอมพิวเตอร์เก็บข้อมูลเป็นบิต "0" และ "1" จึงต้องมีรูปแบบการแปลงรหัสเรียกว่า Unicode Transformation Format (UTF) ซึ่งแบ่งประเภทการใช้งานหลัก ๆ ดังนี้
UTF-8 (Variable-Width: 1 ถึง 4 ไบต์)
- เป็นประเภทที่นิยมมากที่สุดในโลก มีการใช้งานมากกว่า 98% ของเว็บไซต์บนอินเทอร์เน็ต
- ในการทำงาน หากเป็นตัวอักษรภาษาอังกฤษใน ASCII จะใช้เพียง 1 ไบต์ แต่หากเป็นภาษาอื่น เช่น ไทย, จีน หรืออีโมจิ จะขยายขนาดการเก็บข้อมูลเป็น 2, 3 หรือ 4 ไบต์ ตามความซับซ้อน
- ประหยัดพื้นที่มาก และประมวลผลได้รวดเร็ว เมื่อใช้กับข้อความภาษาอังกฤษ
UTF-16 (Variable-Width: 2 หรือ 4 ไบต์)
- ใช้ขนาดขั้นต่ำ 2 ไบต์ (16 บิต) ต่อหนึ่งตัวอักษร
- นิยมใช้ในระบบภายในของตัวระบบปฏิบัติการ เช่น Windows, สภาพแวดล้อมการรันของ Java, JavaScript และ .NET Framework
- เหมาะสมกับภาษาเอเชีย เช่น จีน, ญี่ปุ่น, เกาหลี เนื่องจากอักขระส่วนใหญ่ถูกจัดเก็บด้วยขนาด 2 ไบต์ พอดี
UTF-32 (Fixed-Width: 4 ไบต์)
- กำหนดให้ตัวอักษรทุกตัวใช้พื้นที่คงที่ 4 ไบต์ (32 บิต) เสมอ
- คำนวณตำแหน่งอักษรได้ง่ายเพราะขนาดเท่ากันทุกตัว
- สิ้นเปลืองพื้นที่หน่วยความจำมาก จึงไม่นิยมใช้ในการส่งข้อมูลผ่านเครือข่าย
Unicode ทำงานอย่างไร ? (How does Unicode work ?)
กระบวนการแสดงผลข้อความผ่าน Unicode มีขั้นตอนการทำงานหลัก 3 ระดับ ดังนี้
1. การกำหนดจุดรหัส (Code Point)
Unicode Assign ตัวเลขฐานสิบหกเฉพาะให้แก่ตัวอักษร เรียกว่า Code Point เช่น อักษร A คือ U+0041 โดยสเปกของ Unicode มีพื้นที่ทั้งหมด 17 แพลน (Planes) รวมแล้วสามารถจุตัวอักษรได้ถึง 1,114,112 ตัวอักษร
2. การเข้ารหัสข้อมูล (Encoding Process):
เมื่อซอฟต์แวร์ต้องการบันทึกหรือส่งข้อมูล Code Point เหล่านั้นจะถูกแปลงเป็นลำดับของไบต์ (Byte Sequence) ตามรูปแบบการเข้ารหัสที่เลือก เช่น UTF-8 หรือ UTF-16 เพื่อเซฟลง ฮาร์ดดิสก์ (HDD) หรือส่งผ่านอินเทอร์เน็ต
3. การประมวลผลและการแสดงผล (Rendering & Fonts):
เมื่อระบบปลายทางได้รับข้อมูลไบต์ จะทำการถอดรหัสกลับมาเป็น Code Point แล้วส่งต่อให้ ฟอนต์ (Font) ทำหน้าที่วาดลายเส้น (Glyph) ของตัวอักษรนั้น ๆ บนหน้าจอ
อย่างไรก็ตาม หากเครื่องผู้ใช้ไม่มีฟอนต์ที่รองรับรหัสนั้น ๆ หน้าจอจะแสดงผลเป็นรูปกล่องสี่เหลี่ยม หรือเครื่องหมายขีดเขียนแทน เช่น หรือ [?]
ประวัติความเป็นมาของ Unicode (History and Evolution of Unicode)
จุดเริ่มต้น ช่วงปลายปี ค.ศ. 1980 (พ.ศ. 2523)
วิศวกรจากบริษัทชั้นนำ ได้แก่ Joe Becker, Lee Collins และ Mark Davis จาก Xerox และ Apple ร่วมกับทีมงานจาก Sun Microsystems และ Microsoft เริ่มหารือกันเพื่อสร้างมาตรฐานชุดอักขระสากลใหม่ขึ้นมาแก้ปัญหาความแออัดของรหัสเดิม
ก่อตั้ง Unicode Consortium ปี ค.ศ. 1991 (พ.ศ. 2534)
มีการจัดตั้งองค์กรไม่แสวงหากำไรในนาม Unicode Consortium ขึ้นมา เพื่อทำหน้าที่ดูแล, ปรับปรุง และพัฒนามาตรฐาน Unicode โดยเฉพาะ
Unicode 1.0 มกราคม ปี ค.ศ. 1991 (พ.ศ. 2534)
เปิดตัวมาตรฐาน Unicode เวอร์ชัน 1.0.0 อย่างเป็นทางการ รองรับภาษาหลักทั่วโลก รวมถึงภาษาไทย และอักขระ CJK (จีน ญี่ปุ่น เกาหลี)
การรวมมาตรฐานกับ ISO ปี ค.ศ. 1991 (พ.ศ. 2534)
Unicode ได้ร่วมมือกับองค์กร ISO/IEC เพื่อประสานมาตรฐานให้ตรงกับ ISO/IEC 10646 ทำให้ Unicode กลายเป็นมาตรฐานการเข้ารหัสเดี่ยวระดับสากลแบบตกลงร่วมกัน
ยุคปัจจุบัน
Unicode มีการอัปเดตเวอร์ชันใหม่ทุกปี เพื่อเพิ่มตัวอักษรภาษาท้องถิ่นที่เพิ่งถูกค้นพบ สัญลักษณ์ทางคณิตศาสตร์ และอีโมจิใหม่ ๆ เพื่อตอบสนองการสื่อสารในยุคดิจิทัล
บทสรุปเกี่ยวกับ Unicode (Conclusion of Unicode)
Unicode เป็นนวัตกรรมทางซอฟต์แวร์เบื้องหลังที่ไม่เพียงแต่ช่วยแก้ปัญหาเทคนิคเรื่อง "ภาษาต่างดาว" เท่านั้น แต่ยังเป็นองค์ประกอบสำคัญที่เชื่อมโยงผู้คนทั่วโลกเข้าด้วยกัน หากปราศจาก Unicode เราอาจไม่สามารถส่งข้อความภาษาไทย ใช้งานโปรแกรมข้ามระบบปฏิบัติการ หรือใช้อีโมจิเพื่อสื่อสารความรู้สึกบนโลกออนไลน์ได้อย่างราบรื่นดังเช่นทุกวันนี้
ที่มา : en.wikipedia.org , www.freecodecamp.org , www.twilio.com , deliciousbrains.com , www.techtarget.com , www.lenovo.com


 คำสำคัญ »
|
|
แอดมินสายเปื่อย ชอบลองอะไรใหม่ไปเรื่อยๆ รักแมว และเสียงเพลงเป็นพิเศษ |

ทิปส์ไอทีที่เกี่ยวข้อง


แสดงความคิดเห็น


ทิปส์ไอที ยอดนิยม

ทิปส์ไอทีแนะนำ




Thaiware.com is owned and operated by Thaiware Communication Co., Ltd.